Неделя 17. RLHF, GRPO, DPO
Учиться в приложении: тьютор, задачи с кодом →
Ядро: reward model и Брэдли–Терри, RLHF целиком, GRPO против PPO, DPO из цели RLHF · Глубина: Dr. GRPO, функции награды RLVR, Кондорсе и Эрроу, практика на настоящей модели · ≈ 14 ч ядро / 26 ч всё
Неделя 16 дала механику RL. Эта неделя о том, откуда берётся награда и как её не взломать. Reward model, GRPO и DPO дают три ответа на один вопрос: как превратить предпочтения или проверяемый ответ в градиент. Без этого не понять, как делают reasoning-модели и почему «PPO против GRPO» на самом деле вопрос про baseline, а не про новую конструкцию.
На пальцах. Reward model поставила ответу A оценку 2, а ответу B оценку 1.
По Брэдли–Терри вероятность, что человек предпочтёт A, равна σ(2 − 1) = σ(1) ≈ 0.73.
Человек предпочёл A. Лосс −log 0.73 ≈ 0.31. Это ровно бинарная кросс-энтропия, в которой роль «логита» играет разность наград.
Метка всегда 1, потому что пару записывают так, что первым идёт выбранный ответ.
- Reward model (модель, которая выдаёт ответу число-оценку), модель Брэдли–Терри (вероятность
предпочтения
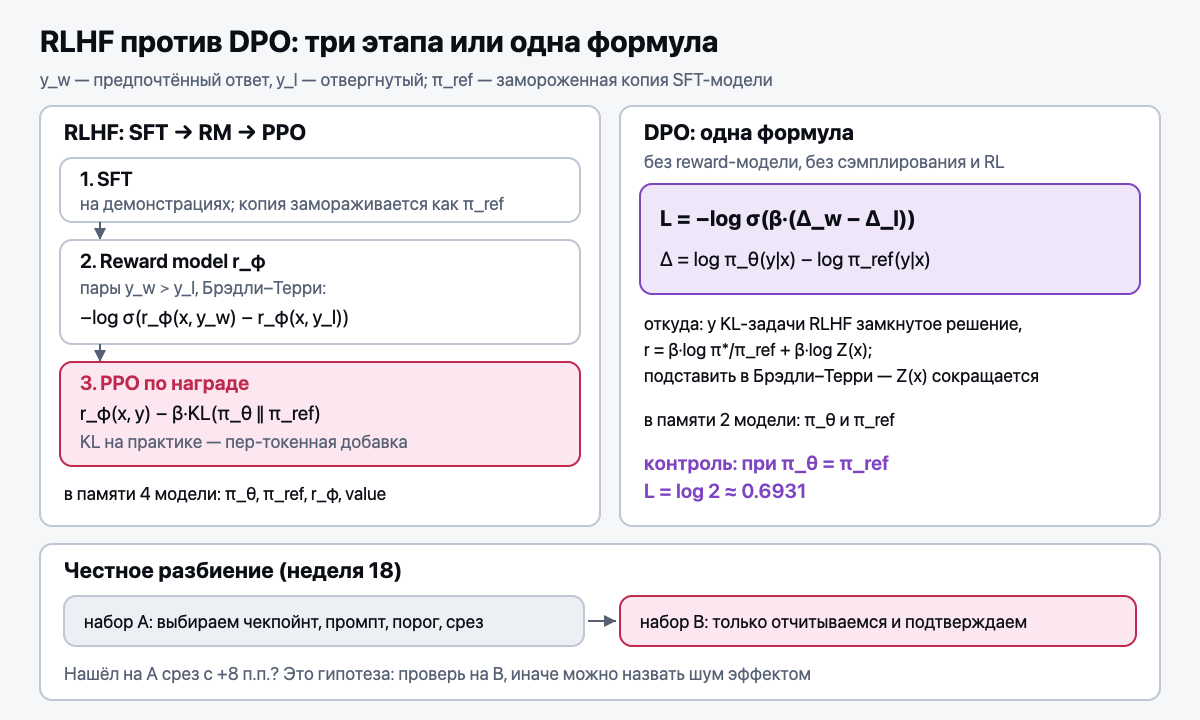
σ(r_A − r_B)). Заметить, что её лосс на самом деле обычная бинарная кросс-энтропия с меткой, всегда равной 1 - Полный конвейер RLHF: SFT → RM → PPO. KL-штраф к референсной модели (замороженной копии SFT-модели), на практике сворачивается в потокенную награду
- Reward hacking (политика получает высокую награду, не делая того, что имелось в виду: например, пишет длинно, потому что RM любит длину)
Откуда сама формула. Брэдли–Терри (1952) вырастает из моделей случайной полезности. У Thurstone (1927) человек
сравнивает не r_A и r_B, а зашумлённые r_A + ε_A и r_B + ε_B и выбирает большее. Нормальный шум даёт пробит
Φ((r_A − r_B)/(σ√2)). Шум Гумбеля (распределение максимума) даёт логистическую разность шумов и ровно σ(r_A − r_B);
к тому же ведёт аксиома выбора Льюса (1959), а для выбора из многих ответов получается softmax.
Следствие: награда задана с точностью до сдвига, r + c даёт те же вероятности. Смысл имеют только разности оценок RM.
Когда предпочтения не укладываются в одно число. Одно число на ответ возможно, только если предпочтения полны
(любые два ответа сравнимы) и транзитивны (из A ≻ B и B ≻ C следует A ≻ C).
На пальцах. Три ответа. Разметчики выбирают A вместо B в 70% случаев, B вместо C в 70%, C вместо A тоже в 70%:
цикл A ≻ B ≻ C ≻ A. Так бывает, когда люди сравнивают по разным признакам: один по краткости, другой по точности.
Каждая пара просит разность ln(0.7/0.3) ≈ 0.85, но три разности по кругу в сумме обязаны дать 0, а не 2.54.
Лучшее, что доступно числам: r_A = r_B = r_C, предсказание 0.5 в каждой паре, лосс ln 2 ≈ 0.693 на пару.
Нижняя граница для любой модели равна энтропии разметки −(0.7·ln 0.7 + 0.3·ln 0.3) ≈ 0.611.
Разрыв 0.082 нат на пару не закрыть никакой архитектурой RM: он заложен в постановку «одно число на ответ».
Почему минимум при равных наградах: лосс пары выпуклый по разности, среднее трёх разностей 0, по неравенству Йенсена
сумма лоссов не меньше трёх значений в нуле. «Лучшего» ответа при цикле нет вовсе: против смеси (⅓, ⅓, ⅓)
каждый ответ выигрывает ровно в половине сравнений.
Цикл Кондорсе и теорема Эрроу. У такого цикла есть имя: цикл (парадокс) Кондорсе. Он возникает, даже когда каждый разметчик по отдельности рассуждает последовательно. Три разметчика: первый ставит A ≻ B ≻ C, второй B ≻ C ≻ A, третий C ≻ A ≻ B. В каждой паре счёт 2:1, и мнение большинства ходит по кругу A ≻ B ≻ C ≻ A. Теорема Эрроу (1951) говорит, что дело не в неудачном правиле голосования: при трёх и более вариантах нет способа свести порядки многих людей к одному общему порядку, который одновременно (1) работает при любых вкусах, (2) ставит A выше B, если так считают все, (3) решает спор A и B только по тому, как люди сравнили именно A и B, и (4) не сводится к вкусу одного человека («диктатора»). Вывод для RLHF: reward model учится на сравнениях многих разметчиков и обязана выдать одну шкалу, поэтому несовместимые вкусы она усредняет. Политика затем оптимизирует вкус «среднего разметчика», которого может не быть среди живых людей, а меньшинство с другим вкусом растворяется в среднем. Подробнее: MIT OCW 6.254, лекция 21 об общественном выборе (ссылка есть и в «Ресурсах»).
Reward hacking глазами экономиста. Экономисты назвали бы это задачей принципала и агента. Принципал (разработчик) хочет качества, но видит только прокси (заменитель цели), оценку RM. Агент (политика) получает плату за прокси, и когда стимулы расходятся, возникает моральный риск: агент делает то, за что платят, а не то, что нужно. Закон Гудхарта (1975) о том же: показатель, ставший целью, перестаёт хорошо измерять. Средства теории контрактов (Хольмстрём, 1979) узнаются сразу: не давать агенту далеко уйти от проверенного поведения (KL-штраф к референсу), платить за проверяемый результат (RLVR), брать несколько независимых сигналов вместо одного, вручную проверять выборку ответов. Это аналогия для интуиции, а не теория того, как устроен RLHF.
На пальцах. На один промпт сэмплируем 4 ответа, проверщик ставит награды (1, 0, 0, 1).
Baseline равен среднему по группе, 0.5; advantages (+0.5, −0.5, −0.5, +0.5), после деления на std 0.5 получаем ±1.
Value-модель не нужна: среднее измерено, а не предсказано. Две поломки видны на тех же числах.
Группа (1, 1, 1, 0) почти целиком решена, но её std 0.43, и неверный ответ получает −1.73:
по модулю больше, чем любой ответ информативной группы.
Если advantage делится на длину ответа, неверный ответ из 16 токенов получает на токен −1/16,
а из 2 токенов −1/2: длинная ошибка наказана в 8 раз слабее.
- GRPO (Group Relative Policy Optimization) = три известные идеи вместе: off-policy суррогат (шаг 3) + клиппинг PPO (шаг 4)
- групповая нормализация advantage. После недели 16 это не новая конструкция.
Value head не нужна: baseline не выучивается, а измеряется сэмплированием.
Больше вычислений (
Gгенераций на промпт), меньше памяти
- групповая нормализация advantage. После недели 16 это не новая конструкция.
Value head не нужна: baseline не выучивается, а измеряется сэмплированием.
Больше вычислений (
- Dr. GRPO: две конкретные поломки GRPO. Деление на
std(r)раздувает градиент на вырожденно лёгких и трудных группах. Нормировка по длине ответа приводит к тому, что среди неверных ответов длинные штрафуются слабее. Модель выучивает, что если не знаешь ответа, надо писать длинно - Вырожденные группы и задачи на границе возможностей. На пальцах. Модель решает задачу с вероятностью
p, в группеG = 4ответа. Если все 4 верны или все неверны, advantages нулевые и градиента нет. Приp = 0.5так выходит в 12.5% групп, приp = 0.9уже в 66%, приp = 0.97в 89%. Формула: доля пустых группp^G + (1 − p)^G, дисперсия наградыp(1 − p)максимальна приp = 0.5. Модель учится, и фиксированный набор задач становится лёгким: сигнал тает. Поэтому задачи подбирают так, чтобыpдержалось в середине: отбрасывают вырожденные группы и досэмплируют новые, либо генерируют задачи программой с настраиваемой сложностью и двигают сложность вслед за моделью (Faro et al., Frontier Learning, 2026). БольшийGтоже помогает: приp = 0.9иG = 16пустых групп 19%
На пальцах. Одна пара: выбранный ответ y_w и отвергнутый y_l, β = 0.1.
На старте π_θ = π_ref, разность лог-отношений 0, лосс −log σ(0) = log 2 ≈ 0.693. Это контрольное значение, оно понадобится ниже.
После обучения log π_θ(y_w) вырос относительно референса на 2, а log π_θ(y_l) упал на 3.
Отступ β·(2 − (−3)) = 0.5, лосс −log σ(0.5) ≈ 0.474.
Тот же лосс выйдет, если оба ответа упадут: выбранный на 1, отвергнутый на 6. DPO смотрит только на разность.
Поэтому при DPO вероятность выбранного ответа может и снижаться.
- DPO: вывести из цели RLHF. У KL-регуляризованной задачи есть замкнутое решение; выразить награду через отношение политик и подставить в Брэдли–Терри → лосс без reward-модели и без RL вообще
- Сравнение PPO / GRPO / DPO / RLAIF (предпочтения размечает модель, а не человек): когда что
- RLVR (RL с проверяемой наградой: ответ сверяет программа), reasoning-модели, test-time compute (больше вычислений при ответе: длинное рассуждение, несколько попыток; подробно в неделе 18, подраздел «Test-time compute»)
Функции награды для RLVR
RLVR (обучение с проверяемой наградой) ставит вместо reward model программу-проверщик: она сверяет ответ с эталоном. Длиной и уверенным тоном программу не подкупить, но её пишет человек, и каждую дыру в ней политика найдёт: reward hacking никуда не делся, он переехал в код проверщика.
На пальцах. Задача в духе GSM8K (школьные текстовые задачи на арифметику): «3 коробки по 4 яблока,
2 яблока съели. Сколько осталось?», эталон 10. Модель учат писать рассуждение, а итог ставить после маркера ####.
Награда складывается из двух частей: 1 за верное число после маркера и 0.1 за формат (маркер ровно один, за ним число).
| Ответ | Правильность | Формат | Награда |
|---|---|---|---|
3·4 = 12, 12 − 2 = 10. #### 10 | 1 | 0.1 | 1.1 |
3·4 = 12, 12 + 2 = 14. #### 14 | 0 | 0.1 | 0.1 |
Осталось 10. | 0 | 0 | 0 |
#### 7 | 0 | 0.1 | 0.1 |
Третий ответ верен по сути, но проверщик числа не видит. Частичная награда, например 0.5 за верное число где угодно в тексте, дала бы ему 0.5. Но тогда ответ «1 2 3 … 100» получает 0.5 на любой задаче: перечислить все числа дешевле, чем решить.
- Почему награда только за формат ведёт к взлому. Если платить только за
#### число, ответ#### 7без всякого рассуждения получает максимум. Политика быстро выучит формат, и все ответы группы получат одинаковые 0.1: сигнал исчезнет, а правильность не сдвинется. Бонус за формат полезен как подсказка на старте и только когда он мал по сравнению с правильностью (0.1 против 1): тогда верный ответ всегда выгоднее красивого - Пустые группы. Если все
Gответов получили одинаковую награду (все 1.1 или все 0),group_advantagesизnanolm/rl.pyвычитает среднее и получает нули, деление наstd + epsнули не меняет. Градиент от такой группы в policy loss ровно нулевой; отдельные KL- и entropy-члены всё ещё могут давать градиент. Долю пустых групп (выше:p^G + (1 − p)^G) стоит писать в лог на каждом шаге. Бонус за формат и частичная награда разбивают ничьи: группа(0, 0.1, 0, 0)уже даёт градиент, но он учит формату, а не решению - Частичная награда нужна, когда полная почти всегда 0 (трудные задачи, маленькая модель): иначе почти все группы пустые. Каждую такую лазейку проверяют на взлом: читают глазами 20 ответов с наибольшей наградой
- Практический ориентир. Универсального порога размера модели для RLVR нет. До обучения измерь долю верных ответов, долю пустых групп и качество проверщика на выбранных задачах. Если почти все награды нулевые, попробуй более доступные задачи или SFT-прогрев. Заранее задай бюджет пилота и критерий остановки: плоская кривая сама по себе не обещает будущего улучшения.
Один шаг GRPO целиком
Для GRPO нужны лог-вероятности токенов ответов. Здесь о том, как их посчитать и в каком порядке идут части одного шага: на этом стыке чаще всего ломается код, который выглядит рабочим.
На пальцах. Промпт «2 + 2 =», ответ из трёх токенов. Модель дала фактическим токенам ответа вероятности
0.5, 0.25 и 0.8. Вероятность ответа по цепному правилу (вероятность последовательности равна произведению
условных вероятностей её токенов) равна 0.5 · 0.25 · 0.8 = 0.1, а её логарифм равен сумме
ln 0.5 + ln 0.25 + ln 0.8 = −0.69 − 1.39 − 0.22 = −2.30 = ln 0.1. Среднее −0.77 даёт e^{−0.77} ≈ 0.46:
это среднее геометрическое вероятностей токенов, а не вероятность ответа. Токены промпта в сумму не входят,
их писала не модель. Паддинг (служебные токены, которыми короткие ответы добивают до общей длины T) тоже не входит.
Сдвиг на один: выход модели на позиции t предсказывает токен t + 1, поэтому вероятность 0.5 первого токена
ответа берут из выхода на последнем токене промпта.
- Сумма или среднее. Лог-вероятность целого ответа равна сумме лог-вероятностей его токенов.
Но GRPO использует отношения по токенам
r_it = exp(log π_θ,it − log π_old,it), а затем агрегирует клиппированные слагаемые. Усреднить logp внутри экспоненты и усреднить готовые слагаемые loss математически не одно и то же. В GRPO сначала усредняют по длине каждого ответа. В DAPO сумму делят на фактическое число активных токенов батча. В Dr. GRPO знаменательB · G · Lиспользует постоянный лимит ответаL, заданный до обучения. Вnanolm/rl.pyпередавай его явно какmax_completion_length, а не как длину текущего тензора. Задачаsequence_logprobотдельно проверяет сумму logp со сдвигом и маской. - Упрощённый GRPO без KL (
β = 0). Многие рецепты RLVR (Dr. GRPO, DAPO) убирают KL-штраф к референсной модели. Проверщик не подкупить гладким текстом так, как reward model, поэтому главный повод держаться у референса слабее. Референс требует ещё одну копию весов в памяти и ещё один проход на каждом шаге. KL к тому же тянет назад длинные рассуждения, ради которых всё и делается. KL возвращают, когда награду ставит обученная reward model (её взламывают), когда портится язык (ответы смешивают языки, зацикливаются) и когда много эпох идут на маленьком наборе задач. Без KL контролируй KL к старой политике, clip fraction и качество ответов: клиппинг не гарантирует близость (неделя 16)
Порядок одного шага на B промптах, с функциями из nanolm/rl.py:
- Сэмплировать
Gответов на каждый промпт текущей политикой с температурой больше 0: при жадной генерации всеGответов совпадут, и группа пустая заранее. Модель в режимеeval(), без градиента. Для учебного on-policy вывода используй температуру 1 без top-k/top-p. Изменённый sampler задаёт другое поведенческое распределение: одного пересчёта logp исходной модели недостаточно для его коррекции. - Поставить награды проверщиком (задача тренажёра
rlvr_reward) и записать в лог долю пустых групп. - Преимущества по группам:
group_advantages, награды формы(B, G). - Старые лог-вероятности
old_logprobs: проход той же модели подtorch.no_grad()и вeval(). Приβ > 0так же считаютref_logprobsзамороженной референсной моделью. - Новые лог-вероятности с градиентом:
sequence_logprobs(потокенно, форма(B·G, T)) и маска ответа. - Потери:
grpo_lossилиdr_grpo_loss; приβ > 0к ним прибавляютβ · kl_penalty_k3(logprobs, ref_logprobs, mask). backward, обрезка нормы градиента, шаг оптимизатора. Если на одних роллаутах делают несколько шагов,old_logprobsне пересчитывают: они и задаютπ_old.
При одном шаге на батч отношение π_θ/π_old тождественно равно 1, клиппинг не срабатывает ни разу, и GRPO
сводится к REINFORCE с групповым baseline (это проверяет test_surrogate_reduces_to_reinforce_at_theta_old
из недели 16). π_old и клиппинг нужны, только когда на одних роллаутах делают несколько шагов.
Где ломается шаг
- Ошибка режима модели. Генерацию и
old_logprobsсчитают в режимеtrain(). Dropout (случайное обнуление части активаций при обучении) на каждом проходе гасит разные нейроны, и два прохода с одинаковыми весами дают разные лог-вероятности. На первом шаге отношениеπ_θ/π_oldобязано быть ровно 1, а выходит 0.9 на одном токене и 1.15 на другом: клиппинг режет градиент там, где политика ещё никуда не сдвинулась.model.eval()выключает dropout, но граф вычислений строит;torch.no_grad()граф не строит, но dropout не трогает. Это два разных переключателя, и нужны оба. В RL-дообучении dropout обычно выключают и в проходе с градиентом (у современных LLM его и так почти нет, неделя 8). Проверка в одну строку: на первом шагеmax |ratio − 1|порядка ошибки округления. Тот же симптом даёт генерация отдельным движком инференса в другой точности: тогдаold_logprobsпересчитывают обучаемой моделью, а не берут у генератора old_logprobsс градиентом. Старые лог-вероятности посчитаны безno_gradи без.detach()теми же весами. Тогда отношениеexp(log π_θ − log π_old)зависит отθи через числитель, и через знаменатель, и его производная равна нулю: лосс считается, а градиент ровно ноль. Памяти на граф уходит вдвое больше- Маска и сдвиг. Лог-вероятности промпта и паддинга попали в сумму, или маску не сдвинули вместе с целевыми токенами и потеряли первый токен ответа. Ловится сравнением с подсчётом в цикле на маленьком примере
Практика на настоящей модели (по желанию). Ноутбук GRPO от Unsloth (ссылка в «Ресурсах»,
раздел Post-training) запускается в бесплатном Colab на T4: LoRA (неделя 15) поверх модели от 1.5B параметров,
задачи в духе GSM8K. Что измерить: награду за правильность и за формат по отдельности на каждом шаге; долю пустых
групп; среднюю длину ответа; 20 ответов с наибольшей наградой (нет ли взлома). Сравни два запуска: с наградой только
за формат и с полной. В первом формат быстро доходит до 100%, а точность на отложенных задачах стоит на месте.
Функцию награды и долю пустых групп можно написать самому в задаче тренажёра rlvr_reward.
Второй путь: GRPO с нуля на MATH (по желанию). Книга Себастьяна Рашки Build a Reasoning Model (From Scratch)
(глава 6, код в репозитории reasoning-from-scratch) и выпуск 6 его видеосерии к книге собирают RLVR и GRPO на PyTorch
без библиотек RL, на задачах MATH (задачи олимпиадного уровня с ответом, который сверяет программа). Ссылки в
«Ресурсах», раздел Post-training. Шаг GRPO там удобно сверять с подразделом «Один шаг GRPO целиком».
Что измерить: точность на отдельной dev-выборке до обучения и каждые несколько десятков шагов.
MATH-500 оставь для итоговой оценки замороженного решения, не выбирай по нему checkpoint или гиперпараметры; среднюю длину ответа отдельно для верных и неверных (рост длины неверных
ответов выдаёт перекос нормировки длины); долю пустых групп; пиковую память GPU при разных G и разной
максимальной длине ответа. Память растёт примерно пропорционально B · G · T (активации прохода с градиентом),
а при β > 0 к ней добавляется референсная модель.
Диагностика GRPO: энтропия, KL и условная награда за формат (углубление)
На пальцах. В группе четыре ответа: все неверные, но один соблюдает формат. При награде
R = C + 0.1F, где C равна 1 за правильность и F равна 1 за формат, получаем (0, 0.1, 0, 0).
Градиент есть, но он поощряет оформление. При R = C + 0.1CF получаем четыре нуля: неверный ответ
не получает бонуса. Цена такого ограничения: если модель пока не решает задачи, обучающий сигнал исчезает.
Это вариант для сравнения на dev-наборе, а не гарантированное улучшение.
К главе 7 Рашки и видео RLVR, часть 2 подходи как к лаборатории диагностики. Ниже уточнения Snula к учебному примеру:
- Среднее advantage не измеряет прогресс. После вычитания среднего оно равно нулю внутри группы
с точностью округления. Стандартное отклонение нормированных advantages обычно близко к 1
для невырожденной группы, если
epsмало относительно разброса наград. Логируй также разброс исходных наград и долю групп с одинаковыми наградами. При сравнении чисел укажи делитель дисперсии:GиG − 1дают разные нормированные значения. - Энтропия измеряет разброс вероятностей, а не правильность. Для двух токенов
(0.5, 0.5)она равна0.6931нат, для(0.9, 0.1)примерно0.3251нат. Формула на позиции ответа:H_t = −Σ_v p(v|prefix) ln p(v|prefix). Суммируй по всему словарю, затем усредняй по выбранным позициям ответа без prompt/padding; укажи, как взвешиваешь ответы разной длины. Зафиксируй, считаешь ли распределение модели до temperature/top-p или распределение сэмплера после них. Для словаря изVтокенов0 ≤ H ≤ ln V; универсального «хорошего H» нет. Рост энтропии вместе с падением точности требует разбора ответов; сам по себе рост не доказывает поломку. - Не смешивай варианты clipping. В главе 7 отношение строится по вероятностям целых ответов;
потокенный GRPO из DeepSeekMath и
nanolm/rl.pyагрегирует отдельные клиппированные слагаемые. Это разные цели. Приclip_eps = 10интервал[1 − eps, 1 + eps]равен[-9, 11]: положительное отношение вероятностей не достигает нижней границы. Не переноси это значение в потокенный loss без обоснования. Клиппинг не задаёт жёсткую границу изменения всей политики. - Проверяй градиент KL, а не только его значение. В учебном скрипте
7_5_plus_kl.pyиспользуетсяβ · mean(log π_θ(y) − log π_ref(y)). При фиксированных ответахyи замороженном референсе производная этого выражения не зависит отπ_ref: вычитается константа. Это не полноценная минимизацияKL(π_θ || π_ref), где само распределение усреднения зависит отθ. Оценкаk3в nanoLM тоже требует различать оценку значения и оценку градиента, а при старых роллаутах учитывать распределение выборки. KL-регуляризация не исправляет ошибочный проверщик. - Теги не доказывают рассуждение. Проверяй формат отдельно от правильности, включая неверный порядок, повторные теги, пустой блок и теги только в prompt. Сверяй token IDs с токенизатором выбранного checkpoint. Добавление специального токена само по себе не обучает модель его смыслу.
Практика без нового обучения. По журналу эксперимента составь таблицу: точность на dev, награды за правильность и формат раздельно, доля пустых групп, энтропия, длина ответа и доля обрывов по лимиту. Для двух подозрительных участков запиши наблюдение, две возможные причины и проверку, различающую их. Недостающую метрику пометь «не записана», не восстанавливай её по виду loss. Для своего повторного эксперимента меняй один фактор, сохраняя модель, данные, sampler и бюджет; выбирай checkpoint по dev, MATH-500 оставляй для итоговой оценки. Логи разных исходных моделей не доказывают пользу одного изменения награды.
Самопроверка дополнения: почему среднее advantage около нуля не означает отсутствие обучения? Почему два разных референса дают одинаковый градиент простого выражения выше на тех же ответах? Что приобретает и что теряет условный бонус за формат, если вся группа ответила неверно?
Код → nanolm/rl.py: group_advantages, grpo_loss, dr_grpo_loss,
kl_penalty_k3, dpo_loss, bradley_terry_loss.
Контроль DPO: при π_θ = π_ref лосс обязан быть ровно log 2 ≈ 0.6931.
Получилось другое? Дальше идти бессмысленно, ищи ошибку.
scripts/rl_demo.py показывает оба перекоса GRPO в числах: вырожденная группа
получает advantage больше информативной, а ответ длиной 16 получает градиент
на токен в 8 раз меньше, чем ответ длиной 2.
Математика (трек D): D25: замкнутое решение KL-регуляризованной задачи; D26: Брэдли–Терри и лосс DPO.
Интервью-вопрос недели: «В чём разница между PPO и GRPO?» Такой вопрос задают дословно. Ответ на 3 минуты, с формулами. После недели 16 он должен звучать как «обе строятся на одном суррогате, различаются только baseline'ом».
Источники: Ouyang et al., InstructGPT (2022); Rafailov et al., DPO (2023); Shao et al., DeepSeekMath (2024), где введён GRPO; Liu et al., Understanding R1-Zero-Like Training, Dr. GRPO (2025); Faro et al., Frontier Learning (2026), задачи на границе возможностей; Cobbe et al., GSM8K (2021); Hendrycks et al., MATH (2021); Lightman et al., Let's Verify Step by Step (2023), срез MATH-500; Yu et al., DAPO (2025); Raschka, Build a Reasoning Model (From Scratch), главы 6–7 (практика, ссылки в «Ресурсах»).
Глубже: 05-ГЛУБИНА, разделы «★★ Недели 16–17. Недостающее звено между REINFORCE и PPO» и «Недели 17 и 21. Немного теории игр».
Результаты недели
- Могу вывести лосс DPO из KL-регуляризованной цели RLHF.
- Могу ответить на «PPO против GRPO» за 3 минуты с формулами.
- Могу объяснить две поломки GRPO, которые чинит Dr. GRPO, с числами из
rl_demo.py. - Могу реализовать
dpo_lossи проверить значениеlog 2приπ_θ = π_ref. - Могу на примере трёх разметчиков объяснить цикл Кондорсе и теорему Эрроу и что из них следует для одной reward model.
- Могу расписать один шаг GRPO от сэмплирования до шага оптимизатора и сказать, где нужны
eval(),no_gradи маска ответа.
Самопроверка
- Почему лосс Брэдли–Терри оказывается бинарной кросс-энтропией с меткой 1?
- Что такое reward hacking? Пример и способ защиты.
- Когда выбрать DPO, а когда GRPO?
- Разметка даёт цикл A ≻ B ≻ C ≻ A по 70%. Каков лучший лосс Брэдли–Терри и почему его не опустить до энтропии разметки?
- Почему GRPO перестаёт учиться на наборе задач, который модель почти решила? Посчитай долю пустых групп при
p = 0.9,G = 8. - Почему награда только за формат ведёт к reward hacking, а бонус 0.1 за формат вместе с наградой 1 за правильность полезен?
- Все 8 ответов группы получили награду 0. Что вернёт
group_advantagesи какой градиент даст группа? Что изменится, если двое из восьми получат бонус за формат? - Почему RLVR может не учить решать выбранные задачи, хотя код верен? Какие показатели пустых групп и правильности это покажут?
- Три разметчика с последовательными вкусами по большинству голосов дают цикл A ≻ B ≻ C ≻ A. Как называется это явление, что утверждает теорема Эрроу и что это значит для одной reward model?
- Ответ из четырёх токенов получил вероятности 0.5, 0.5, 0.8 и 0.5. Чему равна его лог-вероятность, какие позиции исключает маска и как выход модели сдвинут относительно токенов? Почему среднее logp внутри экспоненты не равно усреднению token-wise loss в GRPO?
- На первом шаге GRPO отношение
π_θ/π_oldна части токенов равно 0.9 и 1.15, хотя веса ещё не обновлялись. Какая ошибка режима это даёт и какой проверкой её поймать? Что станет с градиентом, еслиold_logprobsпосчитать безno_grad?